A guerra do ç (e do Ã)
Por estes dias, final de 2026, os jovens devem estar com uma visão pessimista do Brasil atual: ambiente de fim-de-festa, bagunça, cada um por si, até ministros do STF suspeitos de estarem a soldo de quem paga mais. Todos sentem que nos aproximamos de alguma explosão ou singularidade.
Quando comecei a trabalhar com informática, no final dos anos 1980, o Brasil estava numa vibe bem parecida, de desalento. E, para ser justo, as condições materiais da época eram muitíssimo piores que hoje. Uma vantagem de ser velho é já ter constatado in loco que o tempo dá solução a tudo, mesmo no Brasil.
Em particular, na informática de 1990, ainda havia a famigerada reserva de mercado. Já era amplamente execrada e em parte feita letra morta pelo contrabando vindo do Paraguai. Os políticos, para variar, foram os últimos a (querer) enxergar o absurdo daquilo. Peguei literalmente o bagaço da laranja da reserva: o ápice de suas desvantagens, sem nunca ter experimentado suas vantagens.
Imagino que, no início dos anos 1980, os profissionais da área apoiavam a reserva; vislumbravam um futuro róseo (em todos os sentidos que você possa imaginar) com uma pujante e genuinamente nacional indústria de tecnologia, dona do seu próprio nariz. Mais ou menos como nós víamos o software livre na virada do milênio.
Na "minha época" a atitude em relação ao suporte a caracteres não-ASCII (letras acentuadas, símbolos como ª, º, §) era de aberto desprezo. Em parte pela associação a tudo que fosse nacional, como a política de informática; em parte pela grande penetração de computadores e periféricos contrabandeados, que obviamente não suportavam os padrões brasileiros.
Não era um problema trivial para ninguém. Na minha lembrança, nenhum sistema suportava caracteres não-ASCII. Nem bancos, nem entidades de governo, que em tese rodavam equipamento 100% nacional. Chegaram a circular propostas de reforma ortográfica que diminuíssem ou abolissem os acentos e cedilhas. Não era uma questão apenas local. No idioma alemão, definiu-se que "ü" podia ser escrito como "ue" se o trema estivesse inacessível (*3).
Um terceiro fator que certamente pesava era a multiplicidade de padrões para caracteres não-ASCII. Só aqui dentro do Brasil, inventamos dois:
Um era o ABICOMP, criado pela Associação Brasileira de Indústria de Computadores. É o padrão mais antigo, provavelmente o mais bem suportado por equipamentos nacionais, porém sem qualquer semelhança com quaisquer padrões internacionais. O suporte a ABICOMP era obviamente fraco em equipamentos vindos de fora.
O outro padrão era o BRASCII. Este foi criado pela ABNT em 1986 e foi baseado no ISO-8859-1, diferindo deste em apenas dois caracteres menos importantes. Teve menos sucesso que o ABICOMP. Mas foi adotado pelos clones de MSX brasileiros (Expert e Hotbit) e por softwares famosos como o Carta Certa.
Uma vez que o ISO-8859-1 (na verdade, o Windows-1252) tornou-se o padrão dominante nos anos 1990, podemos dizer que o BRASCII teve uma sobrevida melhor. Documentos salvos em BRASCII seriam perfeitamente legíveis até hoje.
Além destes dois padrões genuinamente nacionais, havia o CP850. 850 era o "código de página", ou seja, o conjunto de caracteres do IBM PC que suportava idiomas da Europa Ocidental. O padrão CP860 é semelhante, mas específico para Portugal.
A vantagem do CP850 era o amplo suporte mesmo em equipamentos vindos de fora. Por exemplo, as impressoras Epson matriciais, muito populares na época, disponíveis tanto no mercado legítimo quanto no mercado negro, passaram a suportar CP850 logo em seguida à sua criação. (Isto é, os modelos de impressora lançados após 1987.)
Os fabricantes de PC nacionais tendiam a oferecer CP437 em vez de BRASCII ou ABICOMP, para alinhar seu produto ao ecossistema IBM PC e quiçá viabilizar sua exportação. O CP850 só foi criado em 1987, então demorou um tempo até aparecer algum computador nacional com ele. Na minha lembrança, o primeiro que vi foi um Itautec em 1990, mas posso estar errado.
O suporte a um certo código de página depende da placa de vídeo. Na época, a placa mais comum era a CGA, que vinha com apenas uma tabela de caracteres na ROM. Trocar o code page implicava em trocar a ROM ou a placa inteira. As placas EGA e VGA suportam upload de imagens de caracteres, mas elas só começaram a se popularizar por aqui no finzinho da reserva de mercado.
O grosso dos PCs contrabandeados vinha com placas CGA CP437. Como dito, mesmo os modelos nacionais eram CP437 porque era o "padrão de fato". E preferíamos o CP437 porque ele vinha com um grande conjunto de caracteres semi-gráficos que permitiam desenhar telas, menus, diálogos, etc.
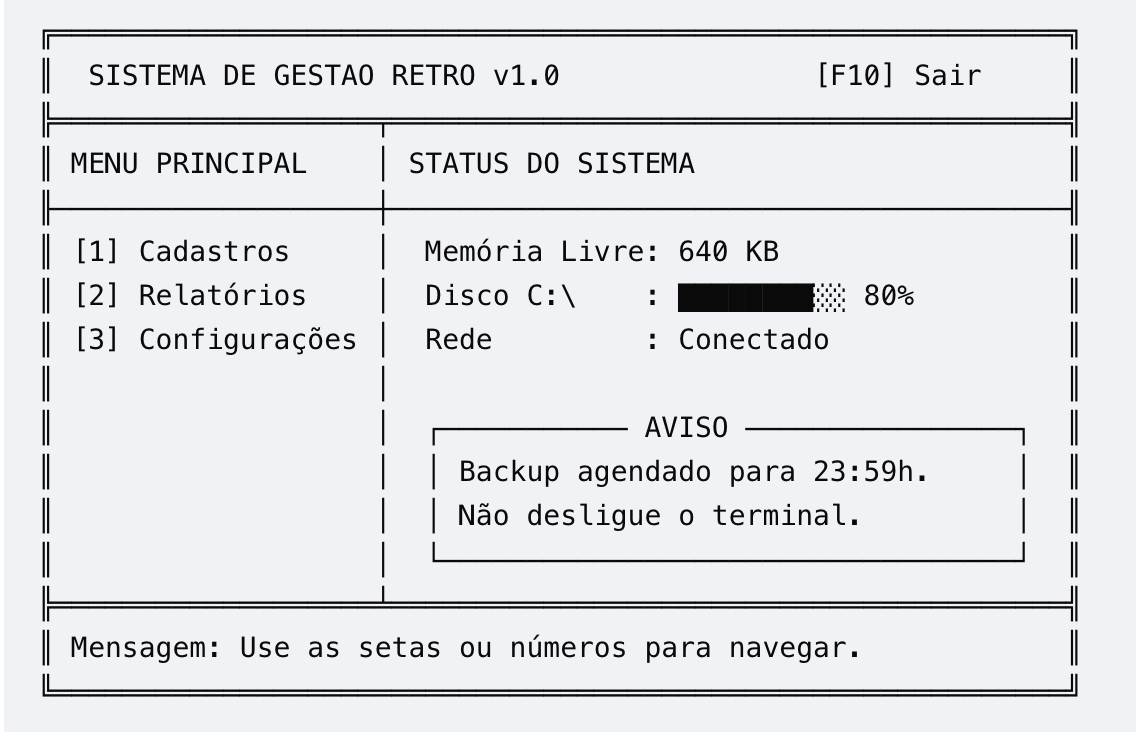
O code page só voga em modo texto, que era o modo utilizado por muitos, mas não todos, os programas MS-DOS. O venerável editor Fácil (*) trabalhava em modo gráfico, e apresentava caracteres acentuados independentemente do code page configurado no PC e no sistema operacional.
As placas EGA e VGA que nos dariam mais liberdade de usar o CP850 em MS-DOS só ficaram mais populares no início dos anos 1990, quase ao mesmo tempo que o Windows começou a substituir o MS-DOS. Como o Windows roda em modo gráfico, o recurso de mudar os caracteres do modo texto caiu no esquecimento. (Eu mesmo só descobri que elas tinham esse recurso ao escrever este texto!)
No mundo ocidental, o Windows adotou o conjunto de caracteres Windows-1252, semelhante ao ISO-8859-1, até as versões 95/98/Me. A partir da versão XP, o Windows adotou Unicode (**).
Como as impressoras imprimiam caracteres acentuados?
Quando a impressora simplesmente não suportava caracteres não-ASCII, o jeito era sobrepor dois caracteres diferentes, enviando o caractere principal, seguido do backspace (Control-H), e finalmente o acento.
A tabela ASCII possui quase todos os caracteres de acentos (agudo, grave, til e circunflexo). Falta o trema e a cedilha. O trema pode ser improvisado com aspas duplas, como se fazia na máquina de escrever. A cedilha era improvisada com a vírgula. Não ficava lindo, mas em todo caso a impressão matricial não primava pela beleza.
Essa era a solução extrema, se a impressora não tivesse nenhum driver nem suporte. Bons programas possuíam drivers para a maioria das impressoras a que tínhamos acesso. (Lembrando que em MS-DOS o driver tem de ser implementado por cada aplicativo, não havia driver no nível do sistema operacional.) Se o editor de texto suportava acentos, ele dava um jeito de imprimir caracteres acentuados, usando CP850, BRASCII ou ABICOMP, o que estivesse disponível.
Outra opção era apelar ao modo gráfico da impressora. Quase todas as impressoras matriciais, mesmo as mais básicas como a Elgin Lady 80, implementavam o padrão "ESC/P", um protocolo criado pela Epson no início dos anos 1980 e que virou um padrão de fato. Um e outro editor de texto, geralmente do gênero desktop publishing, imprimia tudo em modo gráfico.
O modo gráfico era muito lento e exigia muito do software, então não era prático imprimir tudo com ele. Mas permitia alguns truques legais, como imprimir um pequeno logotipo no topo de cada página, e o resto em modo texto.
Unicode, UCS-2, UTF-8, UTF-16
Se serve de consolo, o Brasil não detém o monopólio das decisões desastradas. O Unicode é prova disto.
A ideia original do Unicode era usar caracteres de 16 bits, eliminando o velho problema de haver diversos code pages ou conjuntos de caracteres de 8 bits, um para cada idioma. Em 16 bits, deveriam caber todos os alfabetos e todos os símbolos.
A codificação padrão Unicode é a UCS-2: dois bytes por caractere, big endian. Tecnologias dos anos 1990 como Windows NT, Java e Javascript adotaram UCS-2.
Mas logo inventaram uma versão little endian de UCS-2. Para saber quem é quem, o primeiro elemento de uma string Unicode pode ser o pseudo-caractere 0xfeff (BOM). Se ele se apresentar como 0xff 0xfe, a string é little endian. Se se apresentar como 0xfe 0xff, é big endian. Se não estiver lá, a especificação diz que a string é big endian... porém o Windows presume little endian na ausência do BOM!
O UCS-2 é incompatível com as strings da linguagem C, pois um byte zero não pode mais ser usado para marcar o fim da string. Migrar para strings UCS-2 exige grandes mudanças no software.
No mundo Unix, adotou-se o padrão UTF-8 para representar Unicode. Ele mantém os caracteres ASCII com seus códigos originais de 1 byte, e codifica caracteres Unicode usando uma sequência de bytes de comprimento variável. O UTF-8 é compatível com as strings da linguagem C terminadas em nulo.
As desvantagens do UTF-8 são a) maior complexidade da codificação, b) desvinculação entre o comprimento em bytes e o número de caracteres, e c) pequena possibilidade da string UTF-8 usar muito mais bytes para representar a mesma mensagem.
Porém, surgiu um fato novo que estragou o dia do UCS-2. A tabela Unicode foi ganhando mais e mais caracteres, até que 16 bits não eram mais suficientes.
Para quem já tinha se comprometido com o UCS-2, a solução foi adotar o esquema UTF-16, análogo ao UTF-8. Os caracteres Unicode "originais" continuam ocupando 2 bytes como de costume. Caracteres com valor 0x10000 ou maior são codificados usando uma sequência de comprimento variável.
A solução limpa seria novamente trocar a codificação, adotando UCS-4 (também conhecido por UTF-32) que usa 4 bytes por caractere. Uns poucos sistemas até usam UCS-4. É uma codificação muito ineficiente. Mas o maior problema seria migrar ecossistemas enormes como Windows NT, Java e Javascript. Os "Novos Turcos", que estavam com o rei na barriga por terem adotado Unicode, tiveram o mesmo dilema do velho C e resolveram-no da mesma forma.
No fim das contas, a codificação UTF-8 acabou dominando o mundo. É pragmática, e muito eficiente quando as strings usam poucos caracteres fora da tabela ASCII. Num distante segundo lugar, ainda resiste a dupla ISO-8859-1/Windows-1252.
Mas ainda há muito hardware e software ISO-8859-1 por aí. Se você prestar atenção em cupons fiscais, recibos, tickets de atendimento, cartazes de avisos feitos às pressas, logo vai encontrar um caractere "Ã" ou "Â" num lugar estranho, seguida de um outro caractere aleatório. Por exemplo, a palavra "cão" estaria grafada como "cão".
Isto acontece quando uma string UTF-8 é interpretada como se fosse ISO-8859-1 ou Windows-1252. Quando este acidente ocorre com caracteres Unicode que também existem na tabela ISO-8859-1, a sequência de bytes que os representa sempre tem dois bytes e o primeiro byte é sempre 0xC2 (Â) ou 0xC3 (Ã).
Notas
(*) A empresa que criou o editor Fácil é daqui da terrinha e ainda existe: https://facil.com.br
(**) O Windows NT de 1993 já usava Unicode, porém era uma linhagem "para servidor". A linhagem 95/98/Me era "para desktop", mais compatível com programas MS-DOS e Windows 16 bits de legado, porém menos estável. O Windows XP é baseado no NT e unificou as linhagens.
(*3) A rigor, "ue/oe/ae" precedem "ü/ö/ä". Quando o idioma alemão começou a ser escrito em alfabeto romano, na Idade Média, os escreventes usaram dígrafos para expressar aqueles sons vogais inexistentes na fonética latina. Com o tempo, o "e" extra passou a ser grafado bem pequeno acima da outra vogal, e finalmente virou trema. Embora em desuso, os dígrafos sempre foram considerados válidos na impossibilidade de usar trema.